2026年10月18日 · 作者:@limitlessdeng
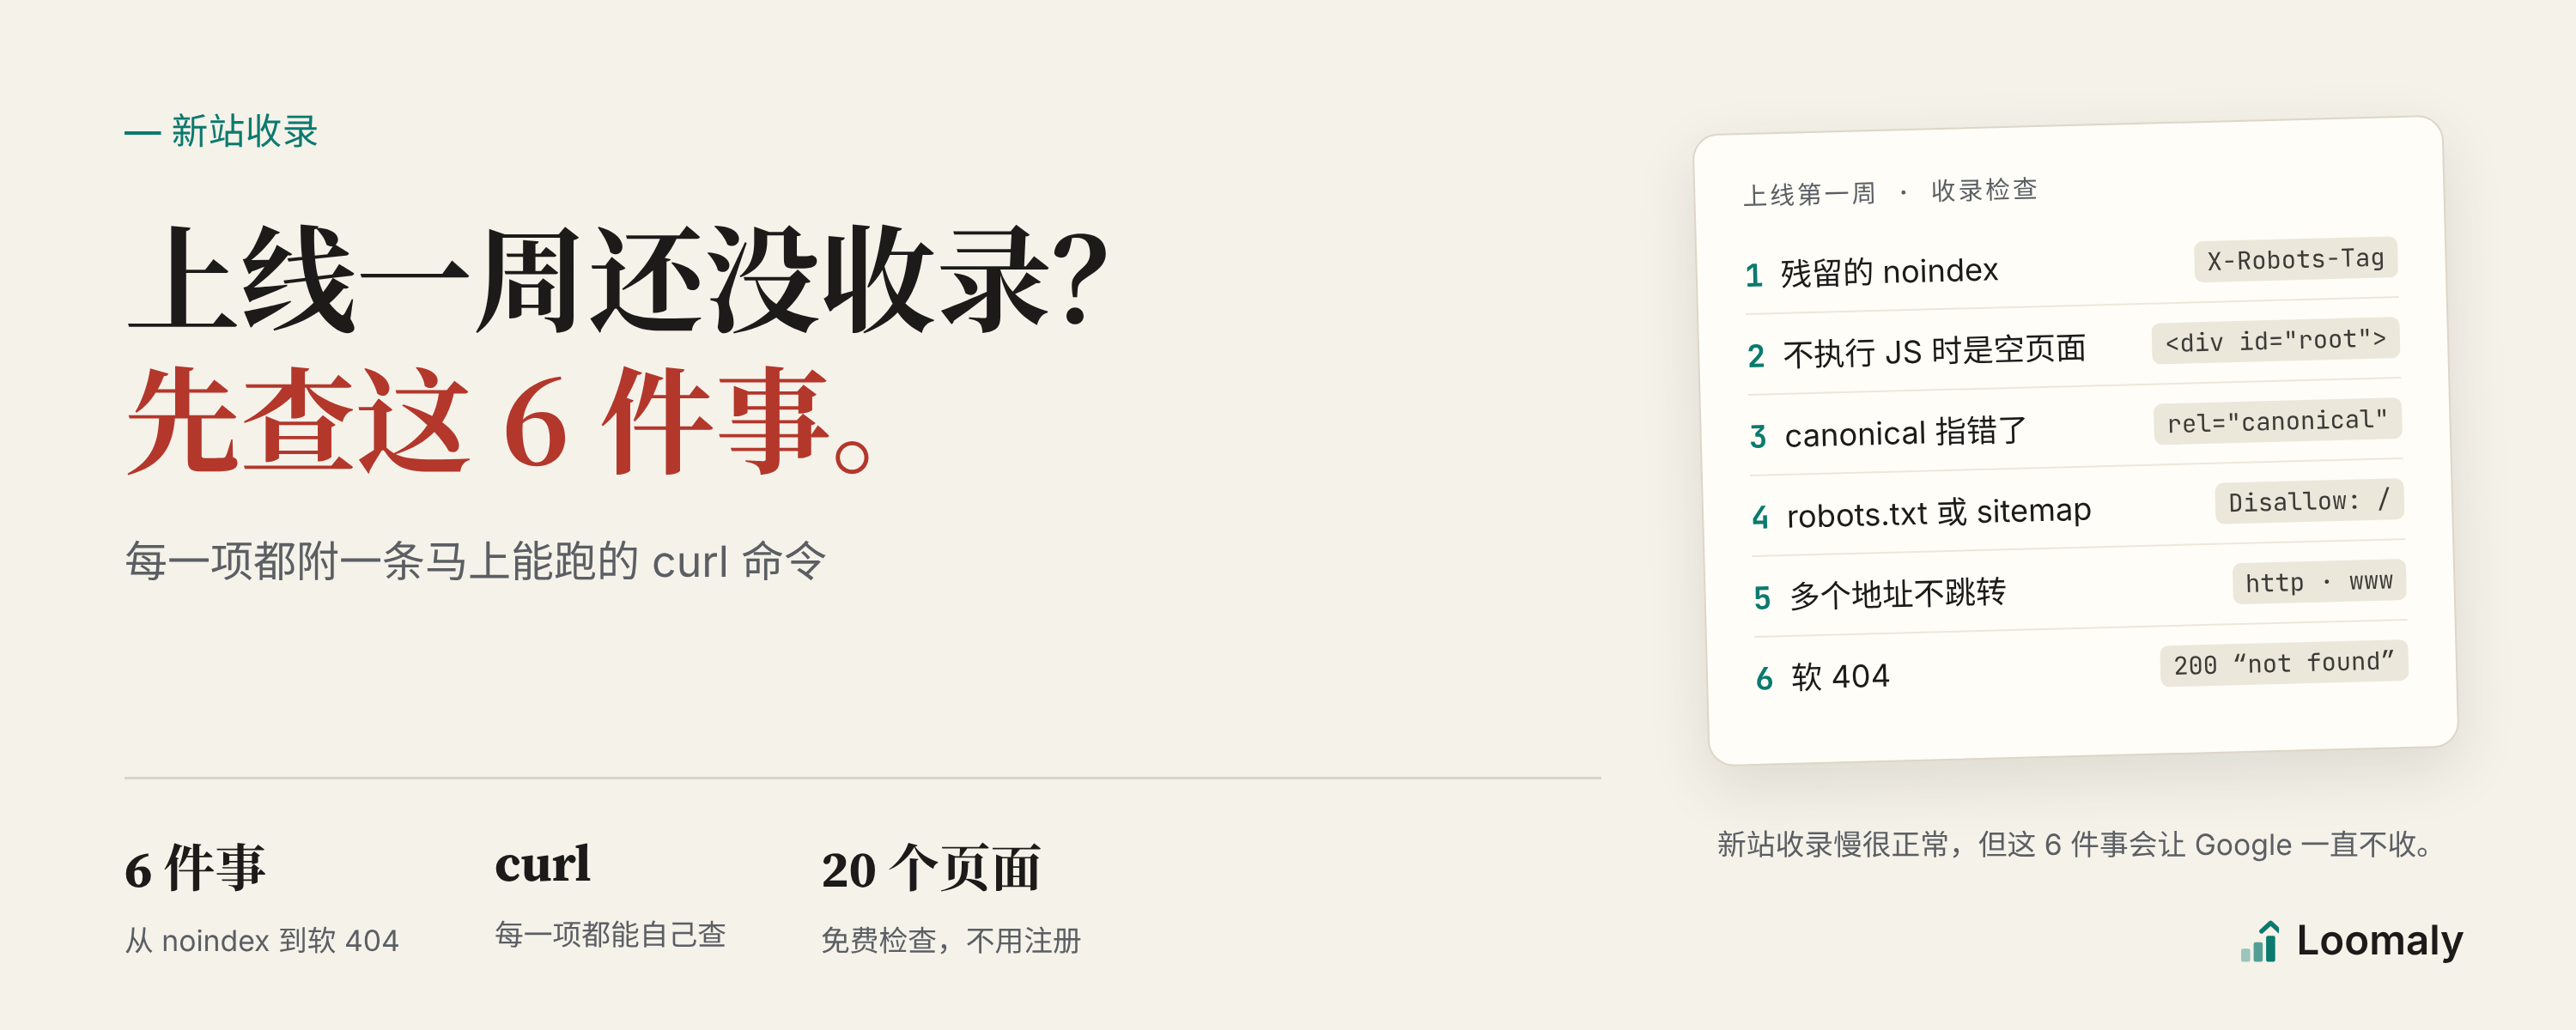
工具站上线一周,Google 还没收录?先查这 6 件事
新站收录慢很正常,但有几类问题会让 Google 一直不收。每一项都给出自己用 curl 查的方法,以及 Loomaly 报出来时叫什么。
工具站上线了,sitemap 也交了,过了一周去 Google 搜 site:你的域名,什么都没有。
先说一个事实:新站收录慢很正常,几天到几周都有可能,Google 不保证什么时候收、收多少。这段时间能做的,是确认网站本身没有挡着它。
下面这 6 件事,每一件都会让 Google 一直不收,或者只收你不想要的那个网址。它们都很常见,大多改一行就好。
1. 页面上还留着 noindex
开发时为了不让测试站被收录,加了 noindex,上线时忘了删。这是最常见、也最冤的一种。
自己查:
curl -s https://你的域名/ | grep -i 'name="robots"'
curl -sI https://你的域名/ | grep -i x-robots-tag
看到 noindex,就是它。meta 标签和 X-Robots-Tag 响应头都要看,后者很多人想不到。
Loomaly 里叫页面设置了 noindex,是错误级。登录、购物车、法律条款这类本来就不该收录的页面不会报。
2. 不执行 JavaScript 时,页面是空的
用 React、Vue 做的单页应用,如果没做服务端渲染或预渲染,服务器返回的 HTML 里只有一个空的 <div id="root">,内容要等 JavaScript 跑完才出现。
Google 会执行 JavaScript,但会排在后面慢慢来。ChatGPT、Perplexity、Claude 这些 AI 爬虫大多不执行,看到的就是一个空页面。
自己查:
curl -s https://你的域名/ | sed 's/<[^>]*>//g' | tr -s ' \n' | head -c 500如果出来的几乎只有标题和一堆空白,你的正文就不在 HTML 里。
Loomaly 的判断标准是:不执行 JavaScript 时,HTML 有 20 KB 以上,正文却不到 150 个字符。规则叫不执行 JavaScript 的爬虫看到的是空页面。修法是开 SSR 或构建时预渲染,主流框架都支持。
查查你自己的网站
免费,无需注册。我们会读取你的 sitemap 和约 20 个页面。
3. canonical 指错了地方
canonical 告诉 Google「这几个网址里,以这个为准」。模板写错时,常见的是所有页面的 canonical 都指向首页,或者指向一个会跳转、打不开的地址。Google 会照着它做,于是你的工具页一个都不收。
自己查:
curl -s https://你的域名/某个工具页 | grep -i 'rel="canonical"'它应该指向这个页面自己。Loomaly 会分别报 canonical 指向了另一个 URL 和 canonical 指向会跳转或打不开的地址。
4. robots.txt 和 sitemap 没写对
robots.txt 里一行 Disallow: /,整个网站就对爬虫关门了。sitemap 如果不是有效的 XML,或者里面列的网址会跳转、带 noindex,Google 会降低对它的信任。
自己查:
curl -s https://你的域名/robots.txt
curl -s https://你的域名/sitemap.xml | head -20
robots.txt 里最好用一行 Sitemap: https://你的域名/sitemap.xml 声明 sitemap 的位置。
Loomaly 对应的规则有 robots.txt 不是有效的规则文件、robots.txt 没有声明 sitemap、sitemap 不是有效的 XML、sitemap 里列了不该收录的网址。另外还有一条:sitemap 里有、但站内没有任何页面链接过去的页面,Loomaly 会报站点地图里没有被任何页面链接的页面。这类孤立页面,Google 往往排得很后。
5. 同一个网站有好几个地址
http://、https://、带 www、不带 www,如果都能打开、互相不跳转,在 Google 眼里就是四个网站在争同一份内容。
自己查:
for u in http://你的域名 https://你的域名 http://www.你的域名 https://www.你的域名; do
  curl -s -o /dev/null -w "%{http_code} %{redirect_url}  $u\n" "$u/"
done
应该只有一个返回 200,其余都 301 跳到它。Loomaly 里叫网站的其他地址没有永久跳转到主地址。
6. 页面状态码不对,或者是软 404
页面返回 404、500,Google 当然不收。更隐蔽的是软 404:页面显示「找不到」或者一片空白,状态码却是 200。工具站的动态路由很容易这样,比如 /tool/不存在的名字 照样返回 200。
自己查:
curl -s -o /dev/null -w "%{http_code}\n" https://你的域名/tool/not-a-real-tool不存在的页面应该返回 404。Loomaly 会报页面返回非 200 状态码,软 404 是靠 AI 读页面判断的,报为错误页面以正常页面返回(软 404)。
都没问题,还是没收录
那就去 Search Console:提交 sitemap,用「网址检查」看 Google 对某个页面的结论,需要的话点「请求编入索引」。Google 实际收没收录,只有 Search Console 说了算,Loomaly 也查不到。
接下来能做的就是等,以及多写几个真正有用的页面,让别的网站愿意链接过来。
一次查完
上面 6 件事,自己用 curl 一个个查也行。想省事的话,Loomaly 的免费检查不用注册,填域名就行,它会抽查你网站最多 20 个页面,报出 noindex、canonical、空页面这类单页问题,以及可能的孤立页面。robots.txt、sitemap、网址变体这类整站检查,在免费注册后的完整扫描里。
查查你自己的网站
免费,无需注册。我们会读取你的 sitemap 和约 20 个页面。